Kiểu dữ liệu enum trong C++
1. Kiểu dữ liệu enum Còn gọi là kiểu dữ liệu liệt kê. Mọi giá trị...
Kết quả sẽ mở trong tab mới, giới hạn trong website này.
Truy cập nhanh
Tìm kiếm gần đây
Token trong AI là từ con chứ không phải từ. Bài này sẽ giải thích vì sao 1 token chỉ khoảng 3/4 từ tiếng Anh, vì sao tiếng Việt tốn token hơn, và cách tự đếm token bằng Python.
Bạn hay nghe “1 token bằng khoảng 3/4 từ” khi dùng ChatGPT hay API của AI. Vậy token trong AI là gì, và sao không cho 1 token đúng bằng 1 từ cho dễ tính? Bài này giải thích ngắn gọn, kèm vài dòng Python để bạn tự đếm token.
Mục tiêu bài học:
Mô hình ngôn ngữ lớn (LLM – Large Language Model) không đọc được chữ. Nó chỉ làm việc với các con số.
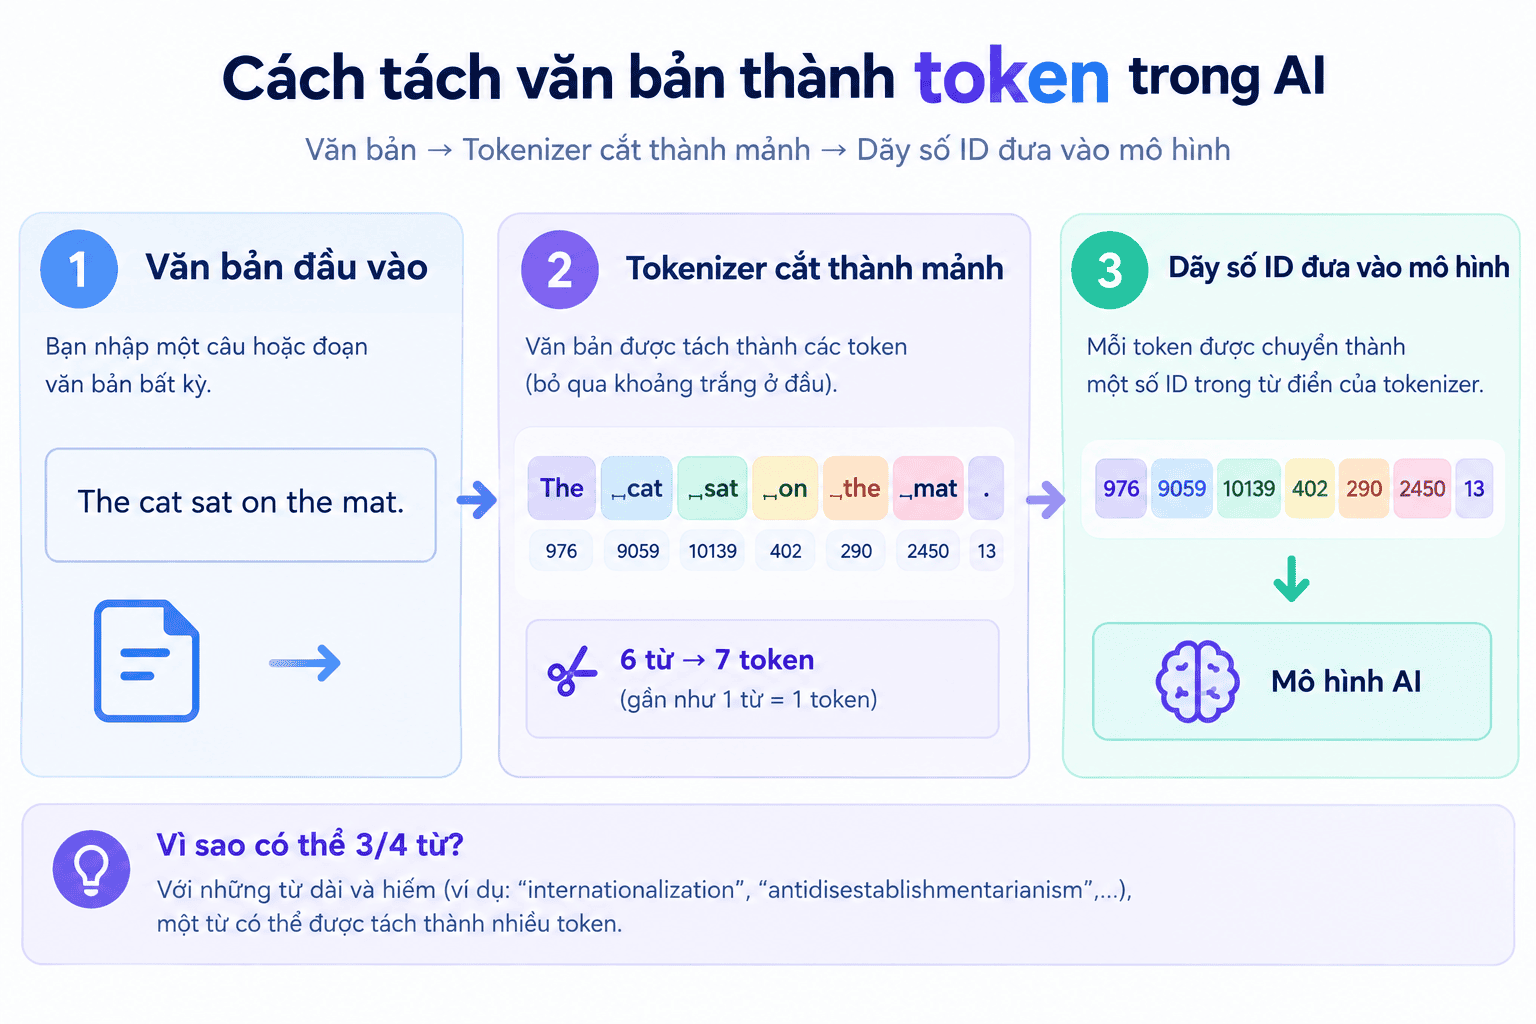
Vì vậy, văn bản phải đi qua bộ tách token (tokenizer). Bộ này cắt câu thành các mảnh nhỏ gọi là token. Mỗi token ứng với một số ID trong bộ từ vựng của mô hình.
Ví dụ với bộ mã hóa o200k_base của GPT-4o, câu “The cat sat on the mat.” được tách thành 7 token:
| Mảnh | The | ␣cat | ␣sat | ␣on | ␣the | ␣mat | . |
|---|---|---|---|---|---|---|---|
| ID | 976 | 9059 | 10139 | 402 | 290 | 2450 | 13 |
Câu này 6 từ ra 7 token, gần như 1 từ 1 token. Thế thì con số 3/4 từ đâu ra? Câu trả lời nằm ở những từ dài và hiếm.
Cắt theo từ nghe hợp lý nhất. Nhưng làm thật thì gặp ba vấn đề.
Còn cắt theo từng ký tự thì sao? Từ vựng rất nhỏ, không bao giờ gặp ký tự lạ. Đổi lại, câu dài gấp mấy lần, mô hình xử lý chậm và tốn bộ nhớ. Giải pháp là đứng giữa hai cách: cắt thành từ con (subword).
Các mô hình GPT dùng thuật toán BPE (Byte Pair Encoding – mã hóa cặp byte). Ý tưởng chính khá đơn giản:
Kết quả: từ phổ biến như “the”, “cat” được gộp trọn thành 1 token. Từ dài hoặc hiếm thì bị tách thành vài mảnh quen thuộc.
| Từ | Cách tách (o200k_base) | Số token |
|---|---|---|
| tokenization | token · ization | 2 |
| internationalization | international · ization | 2 |
| unbelievable | un · bel · ievable | 3 |
| 12345678 | 123 · 456 · 78 | 3 |
Nhờ vậy, từ lạ cỡ nào cũng ghép được từ các mảnh nhỏ. Không bao giờ có chuyện “không biết”.
Đây là quy tắc ước lượng do OpenAI đưa ra cho văn bản tiếng Anh: 1 token ≈ 4 ký tự ≈ 3/4 từ. Nói cách khác, 100 token ≈ 75 từ.
Con số này là trung bình, không phải công thức. Từ ngắn, phổ biến thường đúng 1 token. Từ dài, thuật ngữ, tên riêng thì tốn 2–3 token. Cộng lại, trung bình mỗi từ cần khoảng 1,3 token, tức 1 token ≈ 3/4 từ.
Văn bản càng “dễ” thì tỉ lệ càng cao. Mình thử một đoạn tiếng Anh 70 từ toàn từ thông dụng: ra 77 token, tức 0,91 từ/token. Đoạn văn chuyên ngành, nhiều số hay code thì tỉ lệ thấp hơn hẳn.
OpenAI cũng nói rõ: ngôn ngữ khác có tỉ lệ khác. Tiếng Việt là ví dụ điển hình.
Mình dịch đoạn tiếng Anh ở trên sang tiếng Việt (79 âm tiết) rồi đếm bằng hai bộ mã hóa:
| Đoạn văn | cl100k_base (GPT-4) | o200k_base (GPT-4o) |
|---|---|---|
| Tiếng Anh, 70 từ | 77 token | 77 token |
| Tiếng Việt, 79 âm tiết | 162 token | 102 token |
| Số âm tiết tiếng Việt / token | 0,49 | 0,77 |
Với bộ cũ cl100k_base, tiếng Việt tốn gấp đôi tiếng Anh. Lý do: chữ có dấu chiếm 2–3 byte UTF-8 và ít xuất hiện trong kho văn bản huấn luyện. BPE ít khi gộp chúng lại.
Xem câu “Hôm nay trời đẹp quá” là thấy rõ. Bộ cl100k_base cắt thành 13 token, chữ “đẹp” bị chẻ tới mức từng byte. Bộ o200k_base có từ vựng gấp đôi (khoảng 200 nghìn mảnh) nên chỉ cần 6 token.
Mẹo: Giá API và giới hạn độ dài ngữ cảnh đều tính theo token. Cùng một nội dung, bản tiếng Việt thường tốn token hơn bản tiếng Anh. Khi ước lượng chi phí, hãy đếm token thật thay vì nhân với 3/4.
Thư viện tiktoken của OpenAI cho phép đếm token ngay trên máy. Nếu chưa có Python, bạn xem bài cài đặt Python và VS Code trước nhé. Sau đó cài thư viện:
pip install tiktokenimport tiktoken
# Bộ mã hóa dùng cho GPT-4o
enc = tiktoken.get_encoding("o200k_base")
cau_mau = [
"The cat sat on the mat.",
"unbelievable",
"Hôm nay trời đẹp quá",
]
for cau in cau_mau:
ma_so = enc.encode(cau) # văn bản -> danh sách số ID
manh = [enc.decode([so]) for so in ma_so] # từng ID -> mảnh chữ
so_tu = len(cau.split()) # đếm từ theo khoảng trắng
print(cau)
print(" ID :", ma_so)
print(" Mảnh :", manh)
print(f" {so_tu} từ -> {len(ma_so)} token, tỉ lệ {so_tu / len(ma_so):.2f} từ/token")Hai dòng quan trọng nhất:
enc.encode(cau) biến chuỗi thành list các số ID. Độ dài list chính là số token.enc.decode([so]) dịch ngược từng ID thành mảnh chữ, giúp bạn nhìn thấy chỗ cắt.The cat sat on the mat.
ID : [976, 9059, 10139, 402, 290, 2450, 13]
Mảnh : ['The', ' cat', ' sat', ' on', ' the', ' mat', '.']
6 từ -> 7 token, tỉ lệ 0.86 từ/token
unbelievable
ID : [373, 9880, 45794]
Mảnh : ['un', 'bel', 'ievable']
1 từ -> 3 token, tỉ lệ 0.33 từ/token
Hôm nay trời đẹp quá
ID : [39, 28996, 47447, 177808, 75134, 67118]
Mảnh : ['H', 'ôm', ' nay', ' trời', ' đẹp', ' quá']
5 từ -> 6 token, tỉ lệ 0.83 từ/tokenChạy xong là thấy ngay: chẳng có tỉ lệ cố định nào cả. Mỗi câu một kiểu, con số 3/4 chỉ đúng khi tính trung bình trên văn bản tiếng Anh dài.
Lưu ý: Mỗi hãng AI dùng một bộ tách token riêng. Kết quả của tiktoken chỉ đúng cho các mô hình của OpenAI. Claude, Gemini hay Llama sẽ cho số token khác.
Tóm lại: token là từ con, không phải từ. Cách cắt này giúp mô hình gọn nhẹ mà vẫn đọc được mọi chữ. Còn 3/4 chỉ là trung bình cho tiếng Anh.
1. Kiểu dữ liệu enum Còn gọi là kiểu dữ liệu liệt kê. Mọi giá trị...
1. Khái niệm kế thừa (Inheritance) Tính kế thừa cho phép định nghĩa các lớp mới...
Ngôn ngữ C++ cung cấp một số hàm toán học cơ bản để thực hiện các...

