
Cấu trúc dữ liệu và giải thuật · Phần 7/18
Thuật toán sắp xếp nổi bọt (Bubble Sort)
1. Ý tưởng thuật toán sắp xếp nổi bọt Giả sử cần sắp xếp tăng dần...
Kết quả sẽ mở trong tab mới, giới hạn trong website này.
Truy cập nhanh
Tìm kiếm gần đây
Giải bài tập mã hóa chuỗi "HELLO" theo bảng mã ASCII: đổi sang nhị phân, hexa và tính dung lượng khi lưu bằng ASCII và UTF-16.
Mã hóa thông tin bằng ASCII là cách máy tính đổi mỗi ký tự thành dãy bit. Bài này lấy chuỗi “HELLO” làm ví dụ: đổi từng ký tự sang nhị phân, hexa và tính xem chuỗi chiếm bao nhiêu byte. Nếu chưa vững hệ đếm, bạn nên xem lại bài chuyển đổi giữa các hệ đếm cơ bản trước nhé.
Mục tiêu bài học:
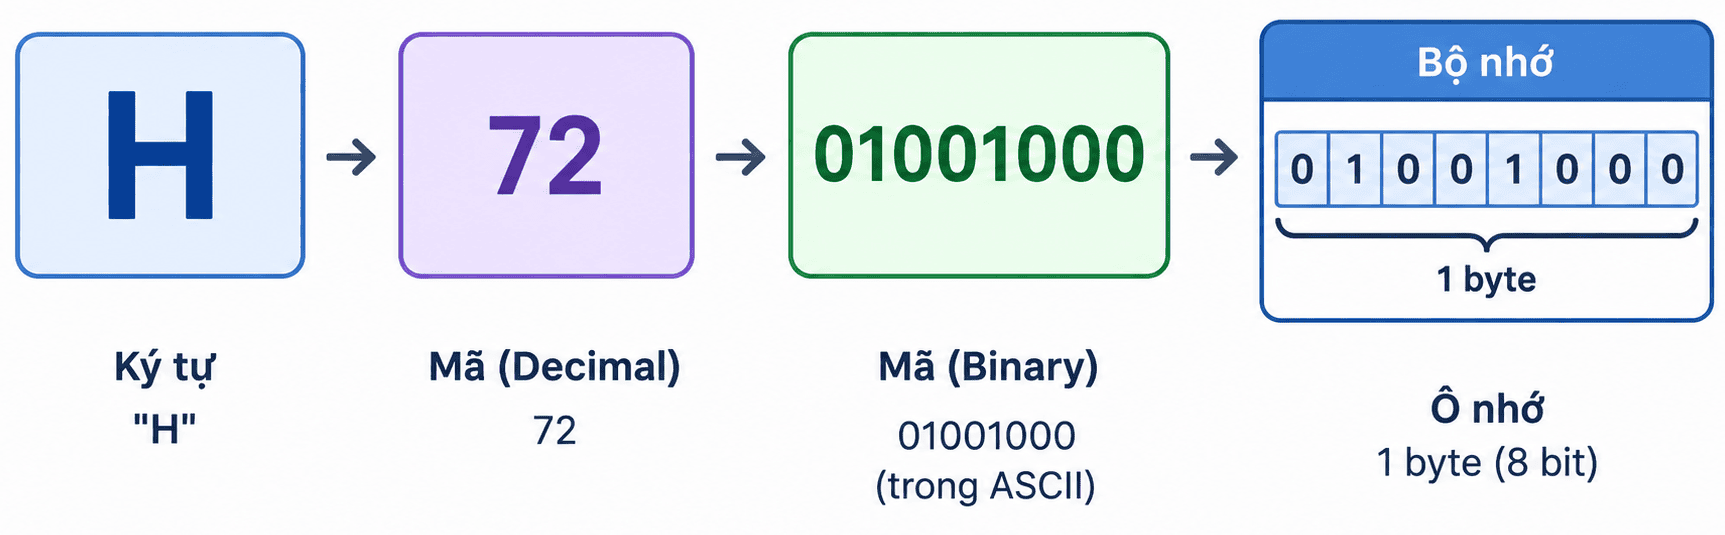
Máy tính chỉ hiểu hai trạng thái 0 và 1. Muốn lưu chữ “A”, trước hết cần quy ước “A” ứng với một con số. Con số đó được đổi sang nhị phân rồi mới ghi vào bộ nhớ.
ASCII (American Standard Code for Information Interchange) là bảng quy ước như vậy. Bảng dùng 7 bit, biểu diễn được 128 ký tự. Trong đó có chữ cái tiếng Anh, chữ số, dấu câu và ký tự điều khiển. Khi lưu vào máy, mỗi ký tự chiếm 1 byte (8 bit) và bit đầu tiên luôn là 0.
| Nhóm ký tự | Mã thập phân | Mã hexa |
|---|---|---|
| Chữ số 0–9 | 48–57 | 30–39 |
| Chữ hoa A–Z | 65–90 | 41–5A |
| Chữ thường a–z | 97–122 | 61–7A |
Mẹo: Chữ thường lớn hơn chữ hoa đúng 32 đơn vị (A = 65, a = 97). Nhớ mẹo này, bạn đổi chữ hoa sang chữ thường (và ngược lại) cực nhanh.
Muốn xem đủ 128 ký tự, bạn tra bảng mã ASCII đầy đủ trên Wikipedia (có cả mã nhị phân, thập phân, hexa). Hoặc tự chạy thử chương trình C++ in ra bảng mã ASCII ngay trên máy của bạn.
ASCII chỉ có 128 ký tự, không có chữ “ệ” hay “ơ” của tiếng Việt. Unicode ra đời để gán mã cho mọi ký tự trên thế giới. Chữ “H” trong Unicode là U+0048, trùng với mã ASCII (48 hexa = 72 thập phân). Unicode giữ nguyên 128 mã đầu tiên của ASCII.
Unicode chỉ là bảng mã. Còn cách ghi các mã đó thành byte được gọi là kiểu mã hóa (encoding), phổ biến nhất là UTF-8 và UTF-16.
| Kiểu mã hóa | Ký tự ASCII | Tiếng Việt có dấu | Emoji |
|---|---|---|---|
| UTF-8 | 1 byte | 2–3 byte | 4 byte |
| UTF-16 | 2 byte | 2 byte | 4 byte |
Lưu ý: UTF-16 không phải lúc nào cũng 2 byte mỗi ký tự. Các ký tự nằm ngoài vùng U+0000 đến U+FFFF (ví dụ emoji) sẽ tốn 4 byte.
Đề bài: Cho chuỗi ký tự “HELLO”.
Đầu tiên, tra bảng ASCII để lấy mã thập phân, sau đó đổi sang hệ 2 và hệ 16. Lấy chữ “H” = 72 làm mẫu:
01001000.48.Làm tương tự với các ký tự còn lại:
| Ký tự | Thập phân | Nhị phân | Hexa |
|---|---|---|---|
| H | 72 | 01001000 | 48 |
| E | 69 | 01000101 | 45 |
| L | 76 | 01001100 | 4C |
| L | 76 | 01001100 | 4C |
| O | 79 | 01001111 | 4F |
Viết gọn, chuỗi “HELLO” ở dạng hexa là 48 45 4C 4C 4F. Hai chữ “L” giống nhau nên mã cũng y chang.
Mẹo: Luôn viết đủ 8 bit. Viết 1001000 thay vì 01001000 là lỗi mất điểm hay gặp nhất.
Mỗi ký tự chiếm 8 bit, chuỗi có 5 ký tự:
5 × 8 = 40 bit. Đổi sang byte: 40 : 8 = 5 byte.
UTF-16 dùng 2 byte (16 bit) cho mỗi ký tự trong “HELLO”. Ví dụ chữ “H” được lưu thành 00 48.
5 × 2 = 10 byte (80 bit), gấp đôi khi lưu bằng ASCII.
Lưu ý: Khi lưu file UTF-16 hoặc chạy code, bạn có thể thấy kết quả là 12 byte. Hai byte dư là BOM (Byte Order Mark – dấu thứ tự byte) đặt ở đầu file. Đề bài chỉ hỏi chuỗi ký tự nên đáp án là 10 byte.
s = "HELLO"

for c in s:
    # ord() trả về mã của ký tự
    print(c, ord(c), format(ord(c), "08b"), format(ord(c), "02X"))

print("ASCII:", len(s.encode("ascii")), "byte")
print("UTF-16 không BOM:", len(s.encode("utf-16-le")), "byte")
print("UTF-16 có BOM:", len(s.encode("utf-16")), "byte")
Kết quả chạy:
H 72 01001000 48
E 69 01000101 45
L 76 01001100 4C
L 76 01001100 4C
O 79 01001111 4F
ASCII: 5 byte
UTF-16 không BOM: 10 byte
UTF-16 có BOM: 12 byte
Định dạng "08b" đổi sang nhị phân đủ 8 chữ số, còn "02X" đổi sang hexa viết hoa.
Tóm lại: ASCII tốn 1 byte mỗi ký tự, UTF-16 tốn 2 byte cho ký tự thông thường. Muốn ôn lại bit, byte, KB, bạn xem bài đơn vị đo thông tin trong máy tính.
1. Ý tưởng thuật toán sắp xếp nổi bọt Giả sử cần sắp xếp tăng dần...
1. Môi trường phát triển tích hợp NetBeans Apache NetBeans (còn gọi là NetBeans) là một...
Khi chọn mua hoặc sử dụng máy tính, chắc hẳn chúng ta đã nghe rất nhiều...